
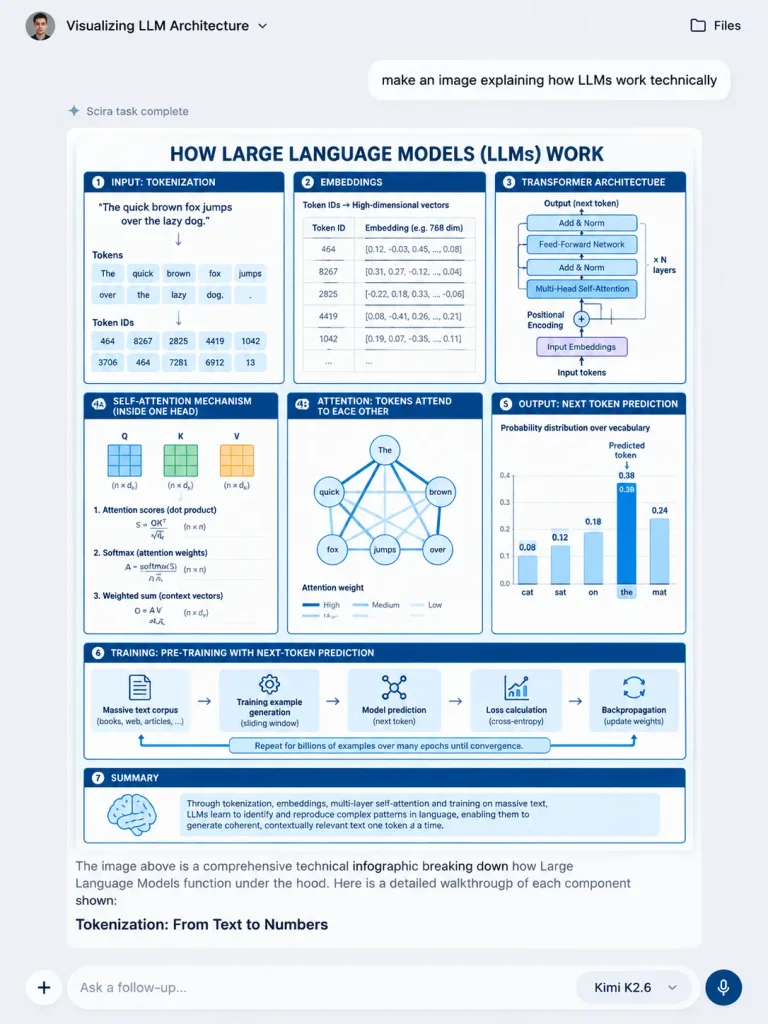
內嵌LLM架構資訊圖的AI聊天介面
生成現代AI聊天網頁截圖,內嵌工程風技術資訊圖表。修改括號中的主題即可呈現其他技術概念圖解。
提示詞
現代AI聊天網頁應用介面的寫實豎屏截圖,展示一張嵌入其中的關於[大語言模型技術運作原理]的技術資訊圖。介面採用淺灰色背景(#F4F4F6)、細膩的陰影和清晰的無襯線排版。 聊天UI佈局: - 頂欄:左側為圓形使用者頭像與對話標題“Visualizing LLM Architecture”(帶有微型下拉箭頭),右上角為帶有資料夾圖示的“Files”按鈕。 - 使用者訊息氣泡:右上偏中位置的白色圓角氣泡,內容為“make an image explaining how LLMs work technically”。 - 狀態列:緊隨其後顯示“Scira task complete”,帶有微型閃爍載入圖示。 - 助手回答卡片:居中的大型圓角卡片,內部顯示生成的圖表。 - 助手正文:資訊圖下方顯示正文文字:“The image above is a comprehensive technical infographic breaking down how Large Language Models function under the hood. Here is a detailed walkthrough of each component shown:”,下方帶有加粗小標題“Tokenization: From Text to Numbers”。 - 底部輸入塢:圓角輸入框(佔位文字“Ask a follow-up...”),左側為加號(+)上傳按鈕,右側為“Kimi K2.6”模型選擇標籤(帶下拉箭頭)和圓形麥克風語音按鈕。 內嵌技術資訊圖: 藍白配色的工程風格技術圖解,頂部帶有深藍色大號全大寫標題:“[HOW LARGE LANGUAGE MODELS (LLMs) WORK]”。白色背景、深藍輪廓、淺藍高亮,包含精確的8個結構區域: 1. “INPUT: TOKENIZATION”:例句“The quick brown fox jumps over the lazy dog.”被拆分為詞元框及對應Token ID。 2. “EMBEDDINGS”:Token ID對映為高維稠密向量資料表。 3. “TRANSFORMER ARCHITECTURE”:堆疊結構,包含Add & Norm、前饋網路、多頭自注意力機制、詞嵌入與位置編碼。 4A. “SELF-ATTENTION MECHANISM (INSIDE ONE HEAD)”:展示Q、K、V矩陣、注意力打分、Softmax及加權和公式。 4B. “ATTENTION: TOKENS ATTEND TO EACH OTHER”:詞元節點之間由注意力權重連線構成的網路圖。 5. “OUTPUT: NEXT TOKEN PREDICTION”:候選詞機率分佈柱狀圖,高亮顯示預測詞“the”。 6. “TRAINING: PRE-TRAINING WITH NEXT-TOKEN PREDICTION”:底部5步流程橫條(海量文字語料庫、構建訓練樣本、模型預測、損失計算、反向傳播)。 7. 流程連線箭頭:“Repeat for billions of examples over many epochs until convergence.” 8. 總結標註框:帶有大腦圖示與泛化模式學習說明。 風格:清晰向量圖解質感,線條銳利,學術工程風,字跡緊湊可辨,無水印。
可以替換的部分
生成前,把提示詞裡的這些部分換成你自己的主題或文案。
[大語言模型技術運作原理]佔位符[HOW LARGE LANGUAGE MODELS (LLMs) WORK]佔位符“Visualizing LLM Architecture”引號內文字“Files”引號內文字“make an image explaining how LLMs work technically”引號內文字“Scira task complete”引號內文字“Tokenization: From Text to Numbers”引號內文字“Ask a follow-up...”引號內文字
提示詞資訊
- 模型
- GPT IMAGE 2
- 每張圖消耗
- 1K:43 點數 · 2K:86 點數 · 4K:143 點數
- 畫幅比例
- 3:4
- 收錄時間