
提示词
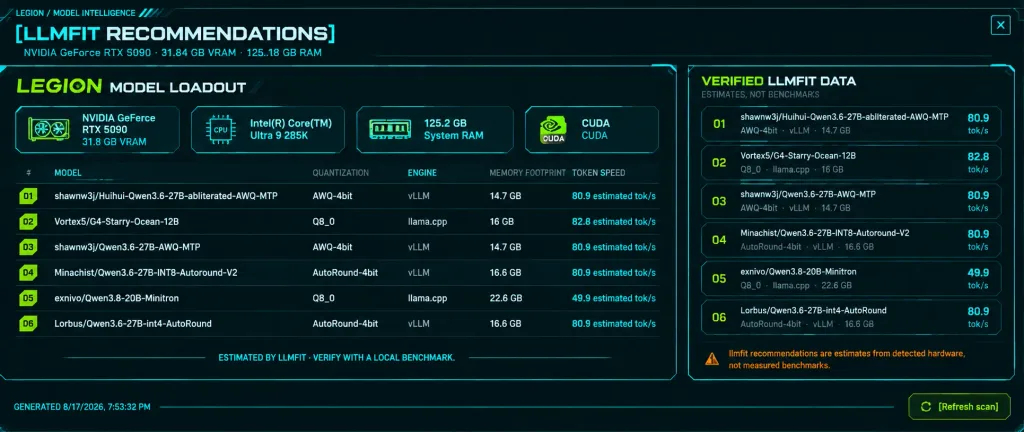
[LLMFIT RECOMMENDATIONS] 的暗黑未来主义仪表板信息图屏幕截图,在超宽屏桌面上展示本地AI模型的性能推荐指标。 场景与画布:超宽21:9比例电脑UI截图。纯黑与深青色背景,带有微弱的环境辉光、纤细的荧光青色边框、微弱的扫描线网格纹理与紧凑的科幻终端UI风格。 顶部栏:小标签“LEGION / MODEL INTELLIGENCE”,大标题“[LLMFIT RECOMMENDATIONS]”,副标题“NVIDIA GeForce RTX 5090 · 31.84 GB VRAM · 125.18 GB RAM”,右上角有关闭按钮图标。 左侧面板(占2/3宽度):主卡片标题为“LEGION MODEL LOADOUT”(“LEGION”为荧光青柠色,其余为白色科技字体)。下方包含4个硬件状态磁贴:1) NVIDIA GeForce RTX 5090, 31.8 GB VRAM(GPU风扇图标);2) Intel(R) Core(TM) Ultra 9 285K(CPU芯片图标);3) 125.2 GB system RAM(内存条图标);4) CUDA(圆形CUDA徽标)。下方是精确的6行排名模型,带有青柠色编号(01-06),显示模型名、量化格式、运行时、占用显存和预估速度: 1) shawnw3j/Huihui-Qwen3.6-27B-abliterated-AWQ-MTP — AWQ-4bit — vLLM — 14.7 GB — 80.9 estimated tok/s 2) Vortex5/G4-Starry-Ocean-12B — Q8_0 — llama.cpp — 16 GB — 82.8 estimated tok/s 3) shawnw3j/Qwen3.6-27B-AWQ-MTP — AWQ-4bit — vLLM — 14.7 GB — 80.9 estimated tok/s 4) Minachist/Qwen3.6-27B-INT8-Autoround-V2 — AutoRound-4bit — vLLM — 16.6 GB — 80.9 estimated tok/s 5) exnivo/Qwen3.8-20B-Minitron — Q8_0 — llama.cpp — 22.6 GB — 49.9 estimated tok/s 6) Lorbus/Qwen3.6-27B-int4-AutoRound — AutoRound-4bit — vLLM — 16.6 GB — 80.9 estimated tok/s 卡片底部中央为细微荧光分割线,文本为:“ESTIMATED BY LLMFIT · VERIFY WITH A LOCAL BENCHMARK.” 右侧面板(占1/3宽度):标题“VERIFIED LLMFIT DATA”,副标题“ESTIMATES, NOT BENCHMARKS”。精确展示6条编号01至06的紧凑条目,带有灰色元数据和青色高光性能分数:80.9, 82.8, 80.9, 80.9, 49.9, 80.9。底部橙色警告:“llmfit recommendations are estimates from detected hardware, not measured benchmarks.” 底部应用状态栏:左下角微小时间戳“GENERATED 8/17/2026, 7:53:32 PM”,右下角带有刷新图标的青柠色边框按钮“[Refresh scan]”。 风格与限制:清晰锐利的科技HUD界面,紧凑的高对比度无衬线技术排版,无真人摄影,全英文文本显示。
可以替换的部分
生成前,把提示词里的这些部分换成你自己的主题或文案。
[LLMFIT RECOMMENDATIONS]占位符[Refresh scan]占位符
提示词信息
- 模型
- GPT IMAGE 2
- 每张图消耗
- 1K:43 积分 · 2K:86 积分 · 4K:143 积分
- 画幅比例
- 21:9
- 收录时间