
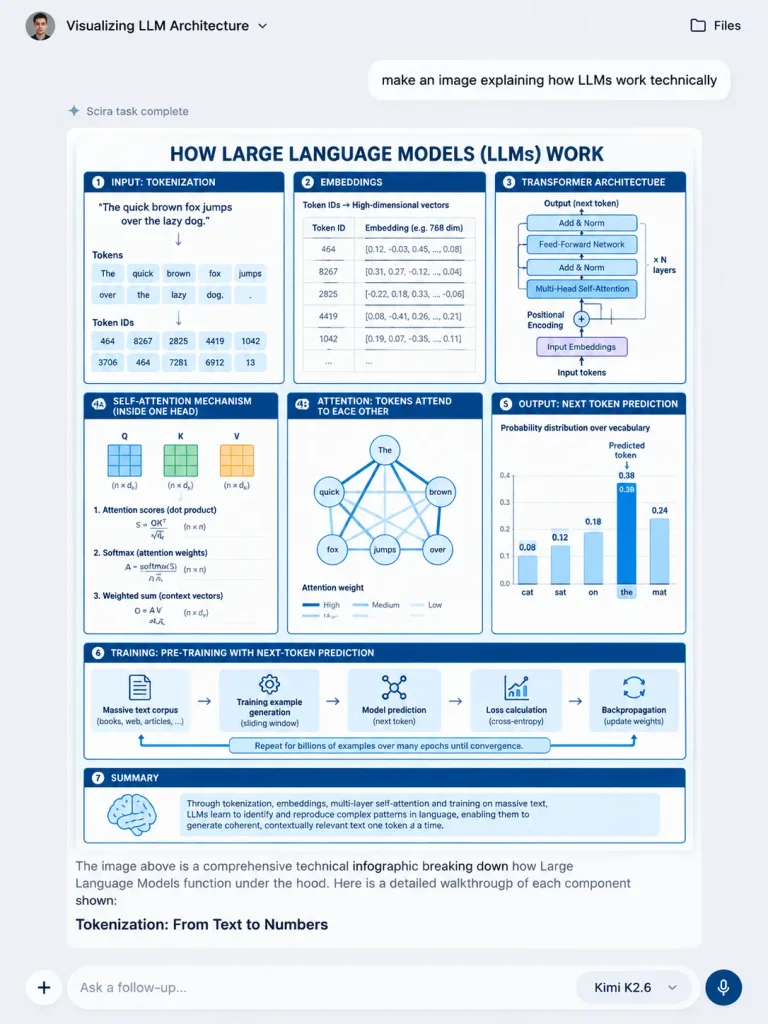
内嵌LLM架构信息图的AI聊天界面
生成现代AI聊天网页截图,内嵌工程风技术信息图。修改括号中的主题可呈现其他技术概念图解。
提示词
现代AI聊天网页应用界面的写实竖屏截图,展示一张嵌入其中的关于[大语言模型技术运作原理]的技术信息图。界面采用浅灰色背景(#F4F4F6)、细腻的阴影和清晰的无衬线排版。 聊天UI布局: - 顶栏:左侧为圆形用户头像与对话标题“Visualizing LLM Architecture”(带有微型下拉箭头),右上角为带有文件夹图标的“Files”按钮。 - 用户消息气泡:右上偏中位置的白色圆角气泡,内容为“make an image explaining how LLMs work technically”。 - 状态栏:紧随其后显示“Scira task complete”,带有微型闪烁加载图标。 - 助手回答卡片:居中的大型圆角卡片,内部显示生成的图表。 - 助手正文:信息图下方显示正文文本:“The image above is a comprehensive technical infographic breaking down how Large Language Models function under the hood. Here is a detailed walkthrough of each component shown:”,下方带有加粗小标题“Tokenization: From Text to Numbers”。 - 底部输入坞:圆角输入框(占位文本“Ask a follow-up...”),左侧为加号(+)上传按钮,右侧为“Kimi K2.6”模型选择标签(带下拉箭头)和圆形麦克风语音按钮。 内嵌技术信息图: 蓝白配色的工程风格技术图解,顶部带有深蓝色大号全大写标题:“[HOW LARGE LANGUAGE MODELS (LLMs) WORK]”。白色背景、深蓝轮廓、浅蓝高亮,包含精确的8个结构区域: 1. “INPUT: TOKENIZATION”:例句“The quick brown fox jumps over the lazy dog.”被拆分为词元框及对应Token ID。 2. “EMBEDDINGS”:Token ID映射为高维稠密向量数据表。 3. “TRANSFORMER ARCHITECTURE”:堆叠结构,包含Add & Norm、前馈网络、多头自注意力机制、词嵌入与位置编码。 4A. “SELF-ATTENTION MECHANISM (INSIDE ONE HEAD)”:展示Q、K、V矩阵、注意力打分、Softmax及加权和公式。 4B. “ATTENTION: TOKENS ATTEND TO EACH OTHER”:词元节点之间由注意力权重连线构成的网络图。 5. “OUTPUT: NEXT TOKEN PREDICTION”:候选词概率分布柱状图,高亮显示预测词“the”。 6. “TRAINING: PRE-TRAINING WITH NEXT-TOKEN PREDICTION”:底部5步流程横条(海量文本语料库、构建训练样本、模型预测、损失计算、反向传播)。 7. 流程连接箭头:“Repeat for billions of examples over many epochs until convergence.” 8. 总结标注框:带有大脑图标与泛化模式学习说明。 风格:清晰矢量图解质感,线条锐利,学术工程风,字迹紧凑可辨,无水印。
可以替换的部分
生成前,把提示词里的这些部分换成你自己的主题或文案。
[大语言模型技术运作原理]占位符[HOW LARGE LANGUAGE MODELS (LLMs) WORK]占位符“Visualizing LLM Architecture”引号内文字“Files”引号内文字“make an image explaining how LLMs work technically”引号内文字“Scira task complete”引号内文字“Tokenization: From Text to Numbers”引号内文字“Ask a follow-up...”引号内文字
提示词信息
- 模型
- GPT IMAGE 2
- 每张图消耗
- 1K:43 积分 · 2K:86 积分 · 4K:143 积分
- 画幅比例
- 3:4
- 收录时间